Comparar respuestas de terapeutas y chatbots exige mirar más que el tono
Un estudio comparó respuestas a dos situaciones ficticias y examinó cómo profesionales valoraban las intervenciones de chatbots.
Edición Neuropsicolucía: 2026-09-21 · Métodos mixtos · 17 terapeutas y tres chatbots · archivo de contexto
En esta noticia
¿Qué diferencias aparecen al responder a los mismos casos guionizados?
- Modelo / participantes
- 17 terapeutas, tres chatbots y dos escenarios ficticios.
- Procedimiento
- Comparación de respuestas y valoración de seis registros de conversación; enfoque de métodos mixtos.
Comparar sin confundir las medidas
17 terapeutas, tres chatbots y dos escenarios ficticios.
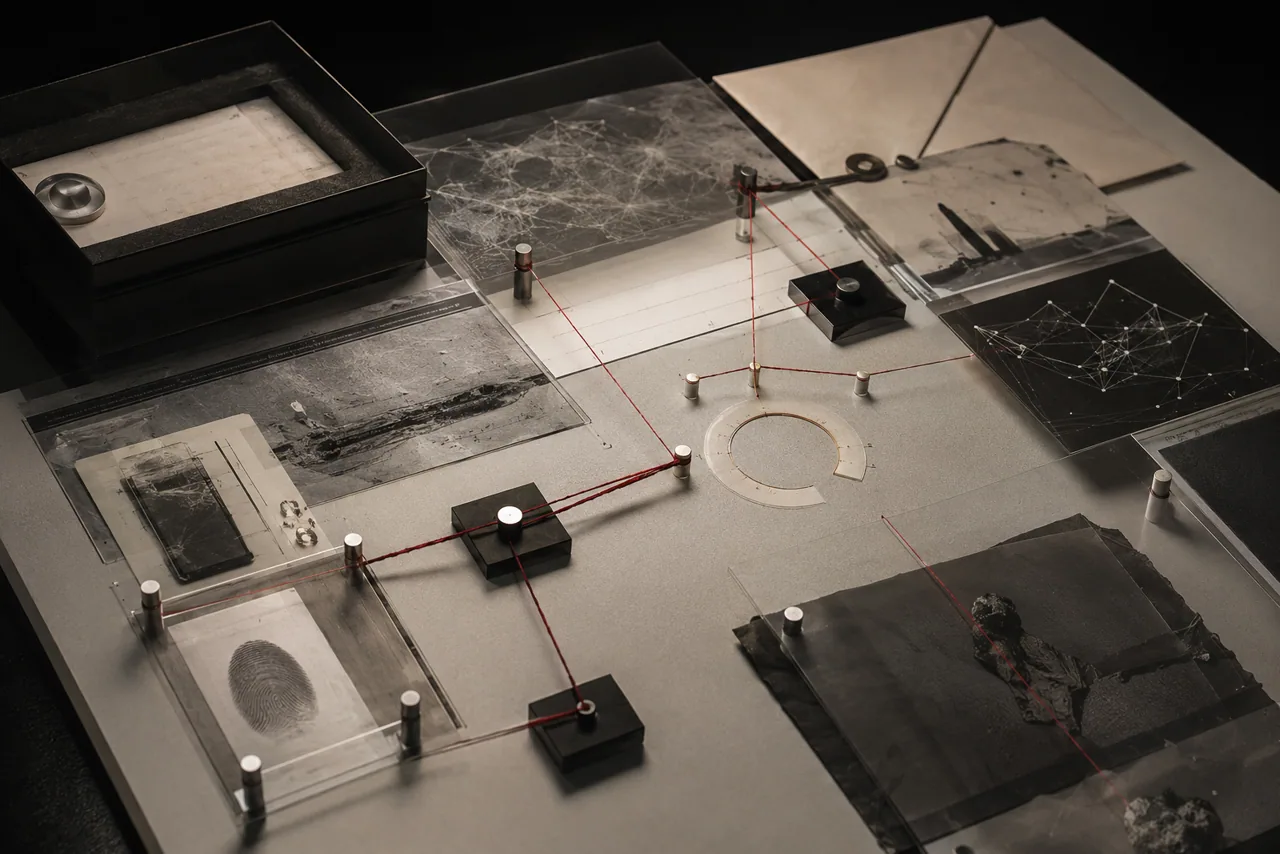
Diagrama editorial del procedimiento; no es una imagen del experimento ni una simulación de sus resultados.
La misma pregunta permite comparar
Usar situaciones comunes a los participantes ayuda a examinar cómo se responde. El guion reduce parte de la variación de una conversación espontánea.
Qué se observa y qué se valora
Los registros permiten revisar intervenciones concretas y recoger valoraciones profesionales. La opinión sobre una respuesta y el resultado de una terapia no son la misma medida.
La prueba que todavía falta
Una relación terapéutica se desarrolla en el tiempo. Estos escenarios no resuelven cómo actuarían los sistemas ante cambios de contexto, información incompleta o seguimiento prolongado.
Qué aporta esta lectura
Comparar respuestas permite examinar procesos concretos, más allá de si el tono parece amable.
Casos guionizados y valoraciones de respuestas no demuestran equivalencia terapéutica ni eficacia clínica.
- Cómo se comportan en conversaciones prolongadas, otras poblaciones y versiones posteriores.
Ampliación revisada el 2026-09-25 · Fuente original consultada
JMIR Mental Health · estudio original ↗